内容摘要
大模型热了两年,“怎么把它接进Java系统"正从加分题变成必答题——而RAG(检索增强生成)几乎是每个企业落地智能问答的第一站。
为什么 RAG 是 Java 团队的第一站
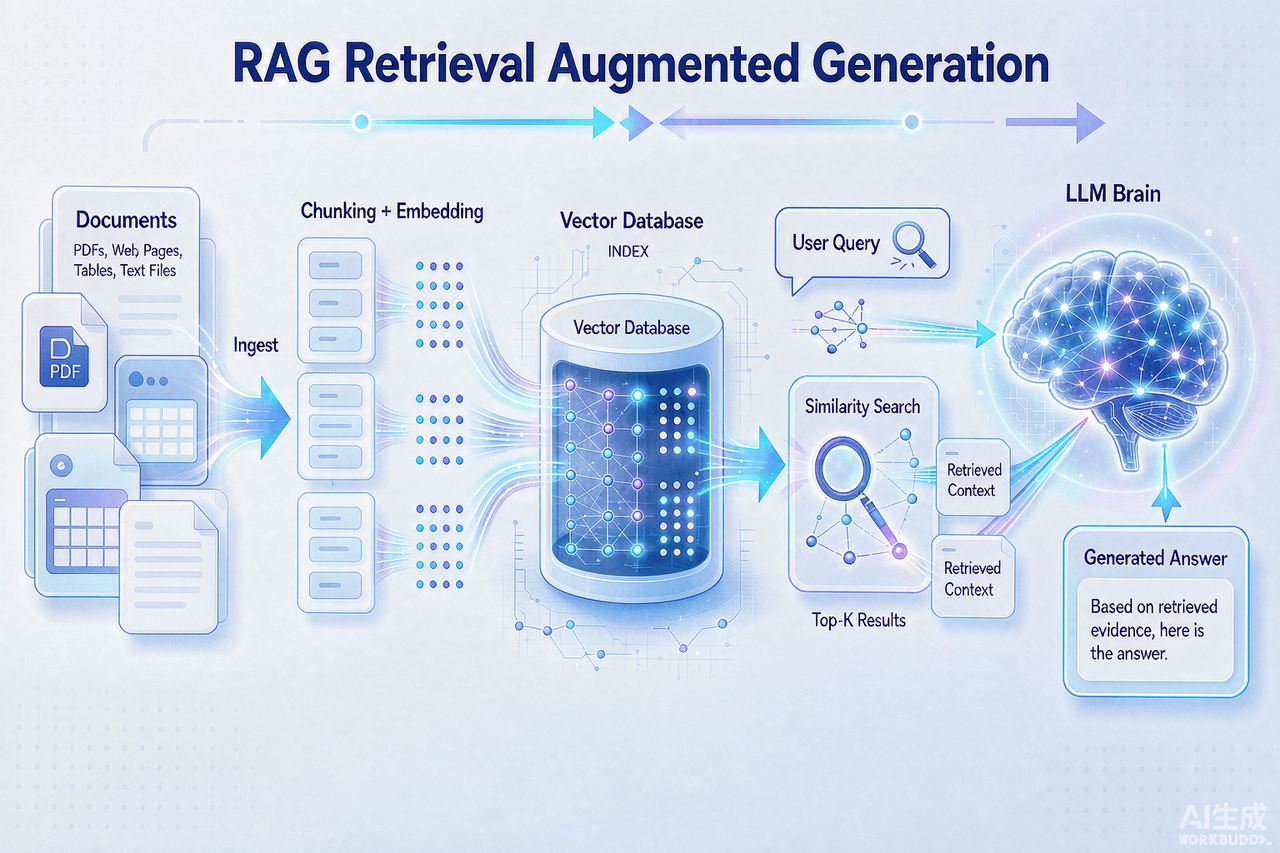
企业真正需要的,不是会聊天的通用模型,而是"懂自己业务"的助手:能回答产品手册、能查内部制度、能基于合同给建议。但通用模型没见过这些私有知识,硬塞prompt装不下,微调又贵又慢。RAG 的解法很朴素——先把企业文档切分、向量化存进向量库,用户提问时先检索出最相关的几段,再连同问题一起交给模型生成答案。它的工程边界清晰,不需要训模型,特别适合 Java 团队在现有系统上"开个智能窗口",所以成了落地首选。
向量库不是黑盒,是另一种"索引"
不少后端第一次接触向量库会觉得玄乎,其实换个角度看就通了:它和关系库里的索引是同一类东西,只是衡量"相似"的不是精确匹配,而是语义距离。文档被切成块、编码成向量,检索时拿问题向量去库里找"最近的邻居"。对 Java 工程师,这层封装得相当友好,主流方案都提供 Java 客户端,写入、查询、过滤写成业务代码并不违和。理解了"它就是一种带语义的检索",RAG 就从神秘降维成"检索加生成"的组合工程,心理门槛一下子就下来了。
工程上的坑比算法多
真正动手才知道,RAG 的难点很少在模型,而在工程。文档怎么切才不会把一句话拦腰斩断?检索回来的块太多会撑爆上下文、太少又答不准,阈值怎么定?答案要带出处、要能溯源,否则没人敢用。还有权限:不同人能检索到的范围不一样,得在检索层就卡住。这些恰恰是 Java 后端最熟悉的领域——数据边界、缓存、权限、可观测。把 RAG 当成"带语义检索的业务服务"来设计,老本事正好派上用场,不必被"AI"两个字吓退。
与现有系统的集成姿势
对 Java 团队最友好的,是 RAG 几乎可以长在原有架构里:知识入库走批处理或消息队列,检索问答做成内部 API,权限复用既有体系,日志监控沿用老栈。模型那一侧可以走网关统一限流、降级、审计——一次推理慢了或挂了,怎么兜底返回"暂时无法回答",都是标准后端题。换句话说,模型是外挂的能力,底座还是你那套成熟的 Java 工程。企业要的正是这种"低风险嵌入",而不是另起炉灶的重写,这也是 Java 工程师在 AI 项目里稳稳占位的原因。
学习者的上手路线
想上手,不必先啃机器学习理论。建议路径:守住 Spring 生态,先跑通一个最小 RAG——把一批文档切分入库、用现成模型做检索问答;再补三块,一是切分与检索策略调优,二是结果校验与降级设计,三是把问答接进真实业务并加上权限与溯源。社区里开源框架和示例很多,照着改比从头写快得多。从一个真实小场景切入,比如客服知识库、制度问答,把链路跑通,比追新概念实在得多。
大模型落地的主战场,不在实验室,在企业系统里。对 Java 开发者,RAG 是一条低门槛、高回报的切入路径——它考验的不是你多懂算法,而是多会把新能力织进老系统。北大青鸟长沙大计的 Java AI 大模型实战开发方向,正是沿"Java 工程底座 + 大模型集成"的路径训练,让学员从写业务代码,走到能交付可溯源、可降级的智能应用。